超能力 / 01
异议:这些对不上
Marshall 会比对他读到的每条消息的结构,并点名那些不一致的——“其中 2 条的 totalCents 是字符串,另外 12 条是数字”——精确到具体的行。不靠模型,不靠 Schema Registry,也不联网:答案就在数据里,而这通常正是你的死信队列被塞满的原因。
把卷宗从头读到尾的那位
 Marshall MQv0.4.0
一款原生 macOS 的 Kafka 和 RabbitMQ 客户端——打开它,看清队列里有什么,找出出问题的那条消息,再也不会被一个其实是“我不知道”的 0 糊弄。
实验室新鲜出炉:v0.4.0 有哪些新东西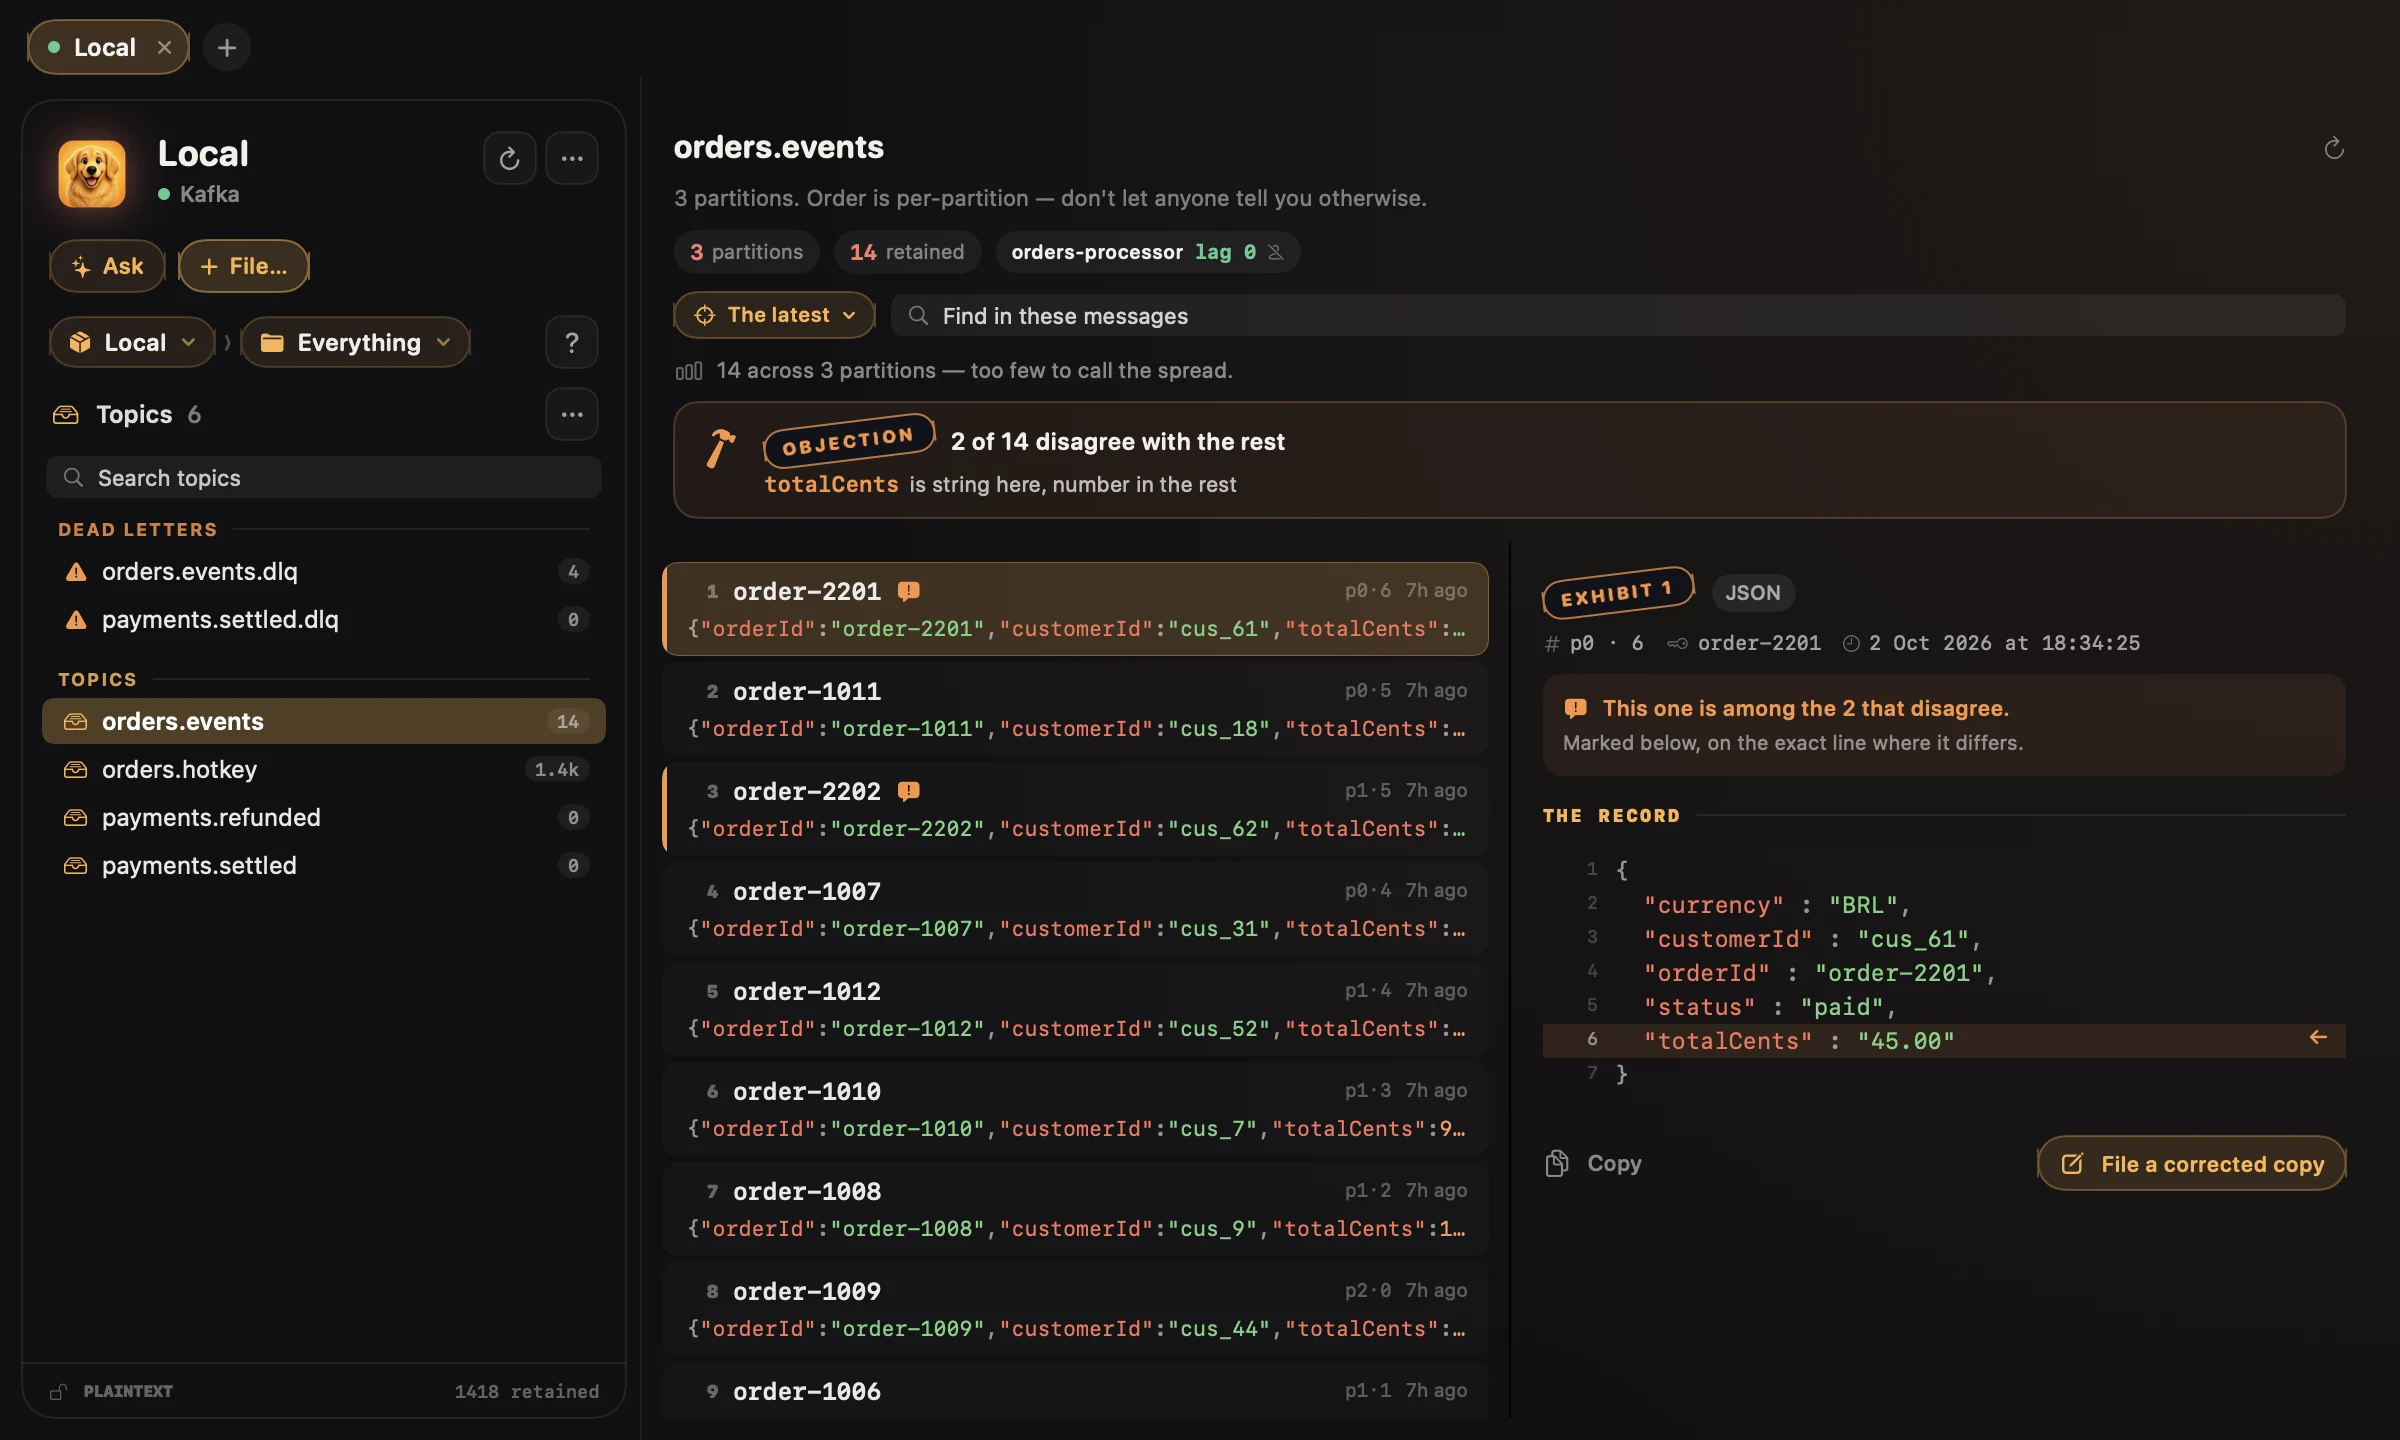
每条消息他都读了。读了两遍。还做了笔记。
我给你画了张图。我画了很多图。
01 / 不只是个好看的图标
7 种方式,让你的日子更轻松。
是的,我们有点上头了。
Marshall 会比对他读到的每条消息的结构,并点名那些不一致的——“其中 2 条的 totalCents 是字符串,另外 12 条是数字”——精确到具体的行。不靠模型,不靠 Schema Registry,也不联网:答案就在数据里,而这通常正是你的死信队列被塞满的原因。
一个主题的消息在各分区里到底怎么分布:有的分区扛着 90% 的流量,有的却空空如也,而它的邻居们早已塞满。热点分区从外面看像是消费者太慢;这张图让你看到它内部的真实样子。
在 Kafka 上,读取就是一次 seek:不加入消费者组,不提交 offset,也不会意外创建主题。把他指向生产环境,谁都不会察觉。
来吧,点开一个。
在 RabbitMQ 上,想查看一条消息就必须先消费它,哪怕立刻放回去,它的 redelivered 标志也会被永久改变。所以在那里读取从来不是自动的——他会先问你,每个 broker 只问一次,用大白话说清楚。
DLQ 会被自动识别并排到最前面,broker 一有响应,他就立刻报告发现了什么——毕竟,一个在夜里被塞满的队列,正是你打开这个应用的原因。
从未提交过的消费者组,延迟是未知的。分布在三个分区里的 14 条消息,撑不起一个比例。Marshall 会说“看不到”和“样本太少,无法判断”,而不是给你一个他无法佐证的安慰数字。
他会读取一份样本,并用大白话解释给你听——借助你 Mac 上已登录的 AI CLI(Claude Code 或 Codex),所以不需要 API key,也不用购买 token。
近距离看看 Marshall MQ 是怎么运转的。
Marshall MQ 是一款原生 macOS 的 Kafka 和 RabbitMQ 客户端。主题会显示它实际保留的消息深度,消费延迟按消费者组展示,死信队列优先呈现,每条消息的键、消息头和负载都清晰可读。他只读,从不打扰:在 Kafka 上,他从不加入消费者组,从不提交 offset,也不会因为查询某个主题就把它创建出来;而在 RabbitMQ 上,查看消息确实会留下痕迹,所以他会事先告诉你,而不是事后。他会比对读到的每条消息的结构,点名那些不一致的;会画一张图,展示你的消息在各个分区里的实际分布;通过你的 Schema Registry 读取 Avro;打开消费者组时先给结论、再给数字——当他看不到某样东西时,他会直说:从未提交过的消费者组,延迟是未知,而不是零。
02 / 是时候确定关系了
几个实用的小细节。
没有尴尬的初次约会问题。
合拍度测试
适用于 macOS。
一上手,就像在家一样。
好东西还不止这些